Разминаем про-strata или запускаем большую языковую модель на обычном пк
в этой статье будет описан опыт запуска qwen 3.8 flash next (модель на 125B параметров) на моем пк с использованием движка strata.
для начала немного про пк, на которых я запускал.
шиз-пк:
- CPU: 2x xeon e5 2698 v4
- GPU: intel arc b580 12gb
- RAM: 64gb ecc ddr4
норм-пк:
- CPU: intel i7 10700f
- GPU: nvidia rtx 3060 12gb
- RAM: 64gb ddr4
скорости генерации (квант IQ3_XXS):
| ПК | генерация | чтение |
|---|---|---|
| норм-пк | 30-50 т/с | 400-500 т/с |
| шиз-пк | 30-40 т/с | 400-500 т/с |
пк относительно нормальные: если не обращать внимание на объем ОЗУ, это единственное отличие от обычного пк.
но в любом случае это все равно самый дешевый вариант локального запуска модели такого размера.
что же, разберем, как это стало возможно.
для начала это стало возможно благодаря ISTA-DASLab, которые квантовали модель Qwen3.8-Flash-Next-GSQ-RCO-GGUF (помимо этой модели есть ещё DeepSeek-V4.1-Flash, Qwen3.8-27B).
вкратце рассмотрим, как проходило квантование модели:
в репозитории представлены следующие кванты: Q2_0, IQ2_XS, IQ3_XXS, IQ3_S. и у любого, кто запускал квантованные модели, назревает вопрос: “какой смысл в квантизации ниже IQ4, ведь такие модели несут бред и уходят в циклы?”
это стало возможно благодаря двум методам — GSQ и RCO, которые, если вкратце, опытным путем распределяют уровень квантизации в зависимости от важности слоя, и в среднем как раз выходит Q2-Q3 квантизация. это уменьшает размер модели до 66-83 ГБ.
разберем чуть подробней.
сначала в чем беда обычных квантов. они равномерные: один и тот же формат заворачивают во все тензоры. но чувствительность у тензоров очень разная — где-то можно отрезать половину бит и модель даже не заметит, а где-то нет. в среднем цифра выходит красивая, а по факту половина модели переквантована, вторая недоквантована.
GSQ и RCO решают это в два приема:
- GSQ (Gumbel-Softmax Quantization) — отвечает за саму квантизацию значений. обычно выбор уровня квантизации для веса — это жесткий argmin, через который градиент не проходит, поэтому квантизацию никто не обучает, а просто подбирают форматы руками. GSQ заменяет argmin на gumbel-softmax релаксацию: выбор уровня становится дифференцируемым, и весь процесс — какой уровень берет каждый вес и какие выходят масштабы групп — учится градиентным спуском на реальных данных. за счет этого на 2-3 битах GSQ выжимает качество почти на уровне векторной квантизации (IQ-форматов с кодбуками), но на выходе — обычный скалярный GGUF.
- RCO (Riemannian Constrained Optimization) — распределитель бюджета. после GSQ у каждого из 352 тензоров есть
Kготовых вариантов с разной битностью, и нужно набрать по одному варианту на тензор так, чтобы среднийbpwпопал ровно в заданный бюджет. лобовой перебор комбинаций нереален, поэтому RCO делает выбор типа вероятностным (softmax по логитам) и переформулирует задачу на гладком римановом многообразии, где бюджетное ограничение выполняется само собой. дальше обычная оптимизация градиентами по лоссу качества, и бюджет сходится точно — без ручной подгонки штрафов и коэффициентов.
дальше все прозаично: база вариантов от GSQ + выбор RCO → склейка в обычный GGUF файл.
и вот почему бреда не будет: на открытых бенчмарках IQ3_XXS (3 бита на вес) сохраняет 99.4% качества базовой модели, а IQ3_S местами даже обгоняет оригинал. так что модель не несет бред
благодаря квантизации модель можно загрузить в оперативную память, но никак не в видеокарту (по крайней мере не в потребительскую). но и для этой проблемы есть решение: qwen 3.8 flash next — это модель архитектуры MoE (Mixture of Experts)
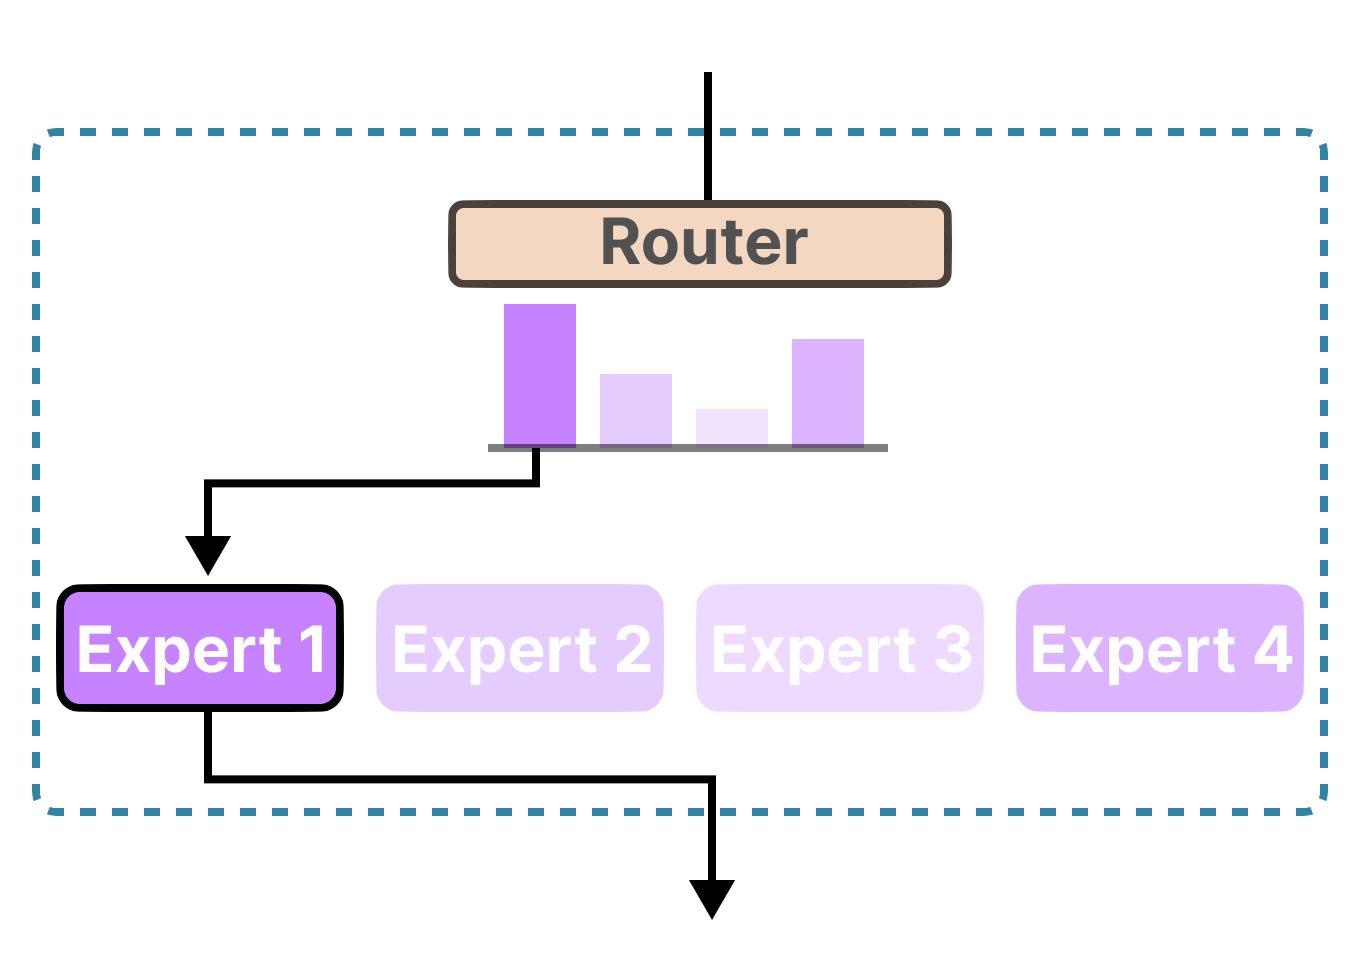
если упрощать, под капотом модель представляет из себя сборище из маленьких моделей — экспертов. при этом при генерации токенов одномоментно используется только 10 экспертов (из 512) — те, которые по оценке оркестратора лучше всего подходят. и я думаю, решение напрашивается само собой: держать в памяти видеокарты только активных экспертов.
и последняя немаловажная деталь — это спекулятивная генерация (предсказание нескольких токенов за раз). в strata ее реализуют MTP и dflash, схема называется 2drafter, и она ускоряет генерацию в несколько раз.
тут тоже разберемся по порядку.
обычная авторегрессия неэффективна: один полный проход большой модели = один токен, и скорость упирается в чтение весов из памяти. спекулятивная генерация меняет схему: маленький и дешевый “черновик” (drafter) за копейки предлагает сразу несколько токенов подряд (окно до 8), а большая модель проверяет их все за один проход — правильные принимает, хвост ошибочных отбрасывает и продолжает с последнего принятого. в итоге один дорогой проход приносит в среднем несколько токенов, а не один.
в strata на эту роль есть два драфтера (потому и схема называется 2drafter):
- MTP (multi-token prediction) — дополнительный слой прямо в основной модели (~1 ГБ), который при ее обучении отдельно учили предсказывать сразу несколько следующих токенов. отдельная модель не нужна.
- dflash2 — отдельная крошечная drafter-модель (~0.7-0.9 ГБ в q4), которую strata тянет параллельно и может сама подбирать под железо.
естественно, у многих должен созреть вопрос: если я могу позволить себе потратить 50+к на оперативку, то, наверное, и на подписку для claude, kimi, deepseek, codex и т.д. наскрести смогу.
и вы будете правы: это нужно далеко не всем. более того, скорость генерации у облачных сервисов выше (около 80 т/с). так кому это может понадобиться?
- корпоративный приватный ИИ. если вы работаете с каким-либо видом “тайны”, то вы не можете использовать обычные сервисы, и разворачивание модели локально может быть выходом (особенно если выделят железо получше, с несколькими картами)
- если вы любитель пошалить, то запуск uncensored моделей
- могу и буду запускать!